足球预测学术研究:11个赛季、3366场比赛,xG模型能否击败赔率?
原文地址
https://journals.sagepub.com/doi/full/10.1177/22150218261416681
抱歉兄弟,已经有接近两个月胜率低迷了,但还是坚信,可以用科学的方法工具战胜赔率差,看到篇很好的文章,给有兴趣在做研究的朋友一些启示
我自己也总结了最近用的所有方法,科学的面对,科学的去探索,加油
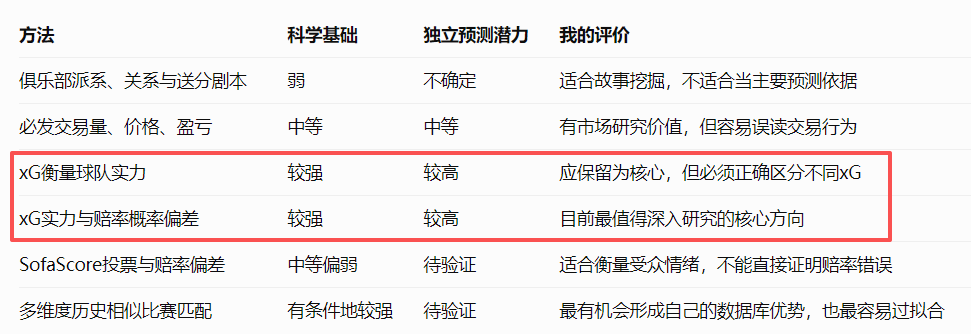
以下是前面那篇论文的总结版本,这个方向我认为值得研究!
足球预测学术研究:11个赛季、3366场比赛,xG模型能否击败赔率?
这篇论文与你长期研究的xG实力偏差、赔率概率偏差、历史相似比赛匹配有很强的关联。它研究的核心不是哪支球队更容易赢,而是:
当xG模型计算的真实胜率与博彩公司赔率所反映的胜率发生分歧时,这种分歧能不能成为具有统计价值的预测信号?
论文发表于2026年2月6日的《Journal of Sports Analytics》,作者为Sascha Wilkens,题目为《Can simple models predict football — and beat the odds? Lessons from the German Bundesliga》(简单模型能够预测足球比赛并战胜赔率吗?德国甲级联赛的经验)。
Sascha Wilkens, 2026
一、最重要的5个研究结论
论文模拟回测的主要结果
3,366
德甲比赛样本,11个赛季
≈10%
使用市场平均赔率的模拟ROI
≈15%
使用市场最优赔率的模拟ROI
主胜
模型利润的主要来源
这些是历史回测表现,不是未来能够保证实现的收益。
1. 赔率总体上比xG模型更准确地反映概率。 博彩公司的胜平负概率在统计校准方面表现更好,但仍可能存在局部定价偏差。
2. 简单xG模型仍能捕捉赔率未充分反映的信息。 这意味着赔率并非完全有效,独立于赔率的实力模型具有研究价值。
3. 模拟收益主要来自主胜方向。 相比之下,客胜方向长期表现不佳,拖累模型整体结果。
4. 概率校准非常重要。 论文采用等渗回归(Isotonic Regression),对xG模型输出的概率进行修正,减少系统性预测偏差。
5. 模型不需要特别复杂,关键在于筛选条件。 并非每场比赛都存在可利用的概率偏差;模型表现也会随着赛季和赛果类别显著变化。
Sascha Wilkens, 2026
二、作者究竟怎样利用xG预测比赛?
论文的技术路线可以分为四步。
第一步:采集两队近期xG数据
评估近期进攻、预期进球与球队实力
第二步:使用Skellam概率模型
将预期进球转化为主胜、平局、客胜概率
第三步:历史赛果校准概率
利用前两个赛季进行等渗回归校准
第四步:与赔率概率比较
计算概率差与预期价值,筛选具有优势的场次
其中第三步值得重点关注。
例如,一个模型将100场比赛的主胜概率预测为60%左右,但这些比赛最终只有52场主胜,说明模型的60%存在高估。
作者使用历史赛果重新校准概率,让模型的数值更接近真实发生频率。这比简单地认定“xG强就应该赢”严谨得多。
Sascha Wilkens, 2026
三、最有意思的数据:567次模拟选择的结果
论文使用平均赔率进行固定金额模拟,得到以下分项表现:
| 方向 | 场次 | 命中率 | ROI |
|---|---|---|---|
| 主胜 | 321 | 36.1% | +16.9% |
| 平局 | 139 | 20.9% | +12.5% |
| 客胜 | 107 | 19.6% | -16.6% |
| 整体 | 567 | 29.3% | +9.5% |
Sascha Wilkens, 2026
这里有一个很值得研究的现象:
命中率并不高,模型依然在回测中实现了正收益。
这是因为作者寻找的是赔率对应概率与模型概率之间的价值差异,而不是追求最高的赛果命中率。
另一个重要发现是:移除等渗回归校准后,整体ROI从约10%下降到约1%。这说明历史数据对概率的校准,在这套策略中发挥了实质性作用。
Sascha Wilkens, 2026
不过论文也发现,近期xG的取样长度会显著影响结果:部分替代窗口甚至产生负收益。这提醒我们不能直接把单个模型配置视为普遍有效规律。
四、结合你的足球分析体系,最值得借鉴什么?
你目前的研究已经包含三种有特色的数据:
- xG实力偏差: xG体现的双方实力与赔率概率是否同步。
- 民众热度偏差: SofaScore投票支持率与赔率概率之间的差异。
- 历史相似匹配: 根据联赛、概差、强势方偏差等条件寻找相似比赛,统计赛果分布。
这篇论文最值得借鉴的,并不是它获得了约10%的历史ROI,而是它提供了一个更严谨的研究方向:
将xG实力差异从描述性指标升级为经过历史校准的胜平负概率,再与市场概率比较。
举一个假设案例:
| 指标 | 主胜 | 平局 | 客胜 |
|---|---|---|---|
| 赔率公平概率 | 45% | 28% | 27% |
| 校准后的xG模型概率 | 54% | 25% | 21% |
| SofaScore民众支持率 | 68% | 18% | 14% |
| xG模型-市场 | +9 | -3 | -6 |
| 市场-民众 | -23 | +10 | +13 |
这样就出现了一个很有研究价值的矛盾:
- xG模型认为主胜被赔率低估了9个百分点。
- 民众却比市场公平概率高出23个百分点支持主胜。
- 从实力模型看,主胜似乎具有价值;从民众热度看,主胜又明显过热。
按照单一反热度方法,可能会排除主胜;按照xG价值方法,反而会关注主胜。
究竟哪种信号在这种矛盾场景下更有效?
这恰好适合利用你的历史数据库做交叉分组回测,而不是先主观判断哪个指标更可信。
我建议重点研究四类比赛:xG与市场一致且民众不热;xG看好但民众过热;xG不看好而民众过热;xG与民众同时反对市场。分别统计主胜、平局、客胜真实发生率,以及不同赔率区间的表现。
这些是基于论文延伸出来的研究建议,并非作者已经验证的结论。
五、这篇论文的局限性
必须特别留意三个问题。
首先,它只研究德国甲级联赛,不能直接推断英超、西甲、意甲、法甲和葡超也有相同表现。
其次,论文采用历史收盘赔率回测。实际使用中还存在成交滑点、下注限制和数据时点等问题,研究并没有完整模拟这些约束。
最后,论文的整体表现虽然为正,但夏普比率偏低、回撤较大,说明其收益波动明显,不能简单解释为一种长期稳定的获利方法。
Sascha Wilkens, 2026
我的研究结论
这篇论文对你最大的价值可以概括为一句话:
独立实力模型可能发现赔率遗漏的信息,但历史概率校准与严格的样本外验证,比单纯寻找较大的xG偏差更重要。
你的现有体系比论文多了一个民众支持率维度。论文没有证明“逆民众热度”有效,但它提供了检验这一假设的统计框架。
下一步最值得做的,是拿你已有的历史xG热度表,建立一个新的**“xG实力—市场赔率—民众热度三方分歧模型”**,分别检测三方同向、两方对立和三方分歧时的真实赛果分布,并用时间顺序划分训练集和测试集,避免历史匹配出现过拟合。
这样不仅能够判断你过去三年的研究规律哪些真正有效,也有机会形成区别于常规赛前预测的原创分析方法。